
服务器崩溃通常不是由单一原因造成的,而是多种因素叠加或某个关键环节被击穿的结果,可以从以下几个维度来理解:

这是服务器“累垮”了,所有资源被吃光,无法响应新请求。
内存(RAM)溢出: 这是头号杀手,常见于代码中存在内存泄漏(申请的内存没释放),或者突发大量请求导致对象堆积,当物理内存和虚拟内存(Swap)都用完时,系统会触发OOM Killer(内存溢出杀手),随机杀掉进程,甚至直接卡死。
CPU(中央处理器)过载: 通常是因为代码逻辑低效(如死循环、未优化的复杂查询)、恶意攻击(如CPU密集型DDoS)或计算任务瞬间暴增,CPU满载会导致进程排队,响应时间急剧上升,最终服务超时无响应。
磁盘空间或I/O(输入/输出)耗尽:
空间满: 日志文件无限增长、数据库binlog撑爆磁盘,导致操作系统无法写入新文件、数据库崩溃。

I/O瓶颈: 大量小文件读写、慢查询导致磁盘队列深度过大,磁盘成为最慢的环节,所有请求都在等磁盘读完才能继续。
网络带宽/连接数耗尽: 服务器网卡出口带宽被占满,或系统最大文件描述符限制(ulimit -n)被突破,导致新连接建立失败,表现为连接超时或拒绝连接。
死锁与线程饿死: 多线程编程中,多个线程互相等待对方释放资源,形成死锁,或者一个持有锁的线程执行缓慢(如调用了慢速API),导致其他所有线程都在等待,系统看起来就像崩溃了。
栈溢出: 递归函数没有正确的终止条件,或者调用层级过深,导致调用栈(Call Stack)撑爆。
致命异常未捕获: 代码存在空指针、除零、数组越界等错误,但未用try-catch处理,会导致进程直接退出(在Java、C++等语言中)。

版本兼容问题: 热更新后新代码与旧依赖不兼容,或配置文件格式错误,导致服务启动失败或运行时异常。
DDoS(分布式拒绝服务)攻击: 通过大量僵尸网络发送合法请求,耗尽带宽、CPU或连接池,使正常用户无法访问。
CC(挑战黑洞)攻击: 针对特定页面(如搜索、登录、支付)发起大量需要占用服务器计算资源的请求。
慢速攻击(Slowloris): 攻击者以极慢的速度发送HTTP请求头部,长期占用连接,耗尽服务器的并发连接数。
存储损坏: 硬盘出现坏道、RAID卡故障导致数据损坏,数据库读取到坏块后崩溃。
电源/散热故障: 机房断电、电源模块损坏,或风扇停转导致CPU/GPU(图形处理器)过热自动关机。
网络设备故障: 交换机/路由器端口故障、光纤损坏导致服务器网络隔离。
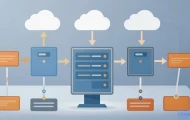
依赖服务雪崩: 服务器的上游服务(如数据库、Redis缓存、认证中心)挂掉,导致本服务器所有依赖它的请求全部阻塞等待,最终线程池/连接池耗尽而崩溃(级联故障)。
错误配置: 比如将数据库连接池上限设置得太低、JVM(Java虚拟机)堆内存参数错误(Xms/Xmx设置不当)、Nginx的worker_connections设得太小。
错误发布: 在有流量的线上服务器上,直接rm -rf / 或覆盖了关键配置文件;或者灰度发布时,流量路由规则配错,将全部流量打给新版本导致雪崩。
容量预估不足: 促销活动/热点事件前未做扩容,或者数据库连接数、QPS(每秒查询数)预估远低于实际峰值。
误操作: 管理员执行了高消耗的SQL(如SELECT * FROM huge_table)、误杀了关键进程、在Slave库上执行了写操作。
单点故障: 所有服务只部署在一台服务器上,没有高可用设计,这台机器坏了,整个系统就瘫痪。
缺乏熔断与限流: 没有保护机制,当流量暴增时,不是优雅地拒绝部分请求,而是让所有请求都冲击数据库和核心服务,最终导致全系统崩溃。
同步调用链过长: 一个请求内部串行调用了5个下游服务,每个都有网络开销,只要其中一个变慢(比如100ms),整个请求就慢5倍,一旦所有请求都慢下来,服务器线程池就会耗尽。
大多数崩溃不是瞬间发生的,而是一个渐进式雪崩过程:
1、诱因: 突发流量、慢查询、内存泄漏、硬件故障等。
2、瓶颈积累: CPU/内存/IO开始排队,响应时间上升。
3、连锁反应: 请求超时后,客户端重试,导致更多请求涌入;线程池被等待的请求填满;新请求被拒绝。
4、系统崩溃: 最终关键资源(如数据库连接池)耗尽,或操作系统因内存耗尽而杀死进程(OOM Kill),服务完全不可用。
监控与报警: 实时监控CPU、内存、磁盘、网络IO、QPS、错误率,设置合理阈值。
容量规划: 基于历史数据做压力测试,预留30%-50%的资源冗余。
限流与降级: 高峰时丢弃非核心请求,保护核心服务。
熔断: 当下游服务失败率达到阈值时,快速失败(Fail Fast)而非继续等待。
优雅关闭: 关闭前先从负载均衡中摘除节点,等待存量请求处理完再重启。
自动化测试: 包括负载测试、混沌工程(主动注入故障,如杀死进程、延迟网络)、回归测试。
如果你有特定的场景(比如某个网站突然无法访问、自己的服务器经常重启),可以提供更多细节,我可以帮你做更针对性的分析。
文章摘自:https://idc.huochengrm.cn/js/26973.html
评论
纪问春
回复服务器崩溃可能由硬件故障、软件错误、过载、恶意攻击、电源问题、配置不当、操作失误等多种原因引起。